La Estadística trata del recuento, ordenación y clasificación de los datos obtenidos por las observaciones, para poder hacer comparaciones y sacar conclusiones.
Un estudio estadístico consta de las siguientes fases:
Recogida de datos.
Organización y representación de datos.
Análisis de datos.
Obtención de conclusiones.
Conceptos de Estadística
Población
Una población es el conjunto de todos los elementos a los que se somete a un estudio estadístico.
Individuo
Un individuoo unidad estadística es cada uno de los elementos que componen la población.
Muestra
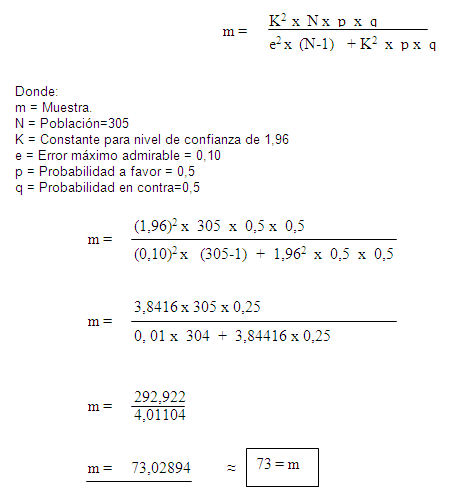
Una muestra es un conjunto representativo de la población de referencia, el número de individuos de una muestra es menor que el de la población.
Muestreo
El muestreo es la reunión de datos que se desea estudiar, obtenidos de una proporción reducida y representativa de la población.
Valor
Un valor es cada uno de los distintos resultados que se pueden obtener en un estudio estadístico. Si lanzamos una moneda al aire 5 veces obtenemos dos valores: cara y cruz.
Dato
Un dato es cada uno de los valores que se ha obtenido al realizar un estudio estadístico. Si lanzamos una moneda al aire 5 veces obtenemos 5 datos: cara, cara, cruz, cara, cruz.
Una variable estadística es cada una de las características o cualidades que poseen los individuos de una población.
Tipos de variable estadísticas
Variable cualitativa
Las variables cualitativas se refieren a características o cualidades que no pueden ser medidas con números. Podemos distinguir dos tipos:
Variable cualitativa nominal
Una variable cualitativa nominal presenta modalidades no numéricas que no admiten un criterio de orden.
Ejemplo:
El estado civil, con las siguientes modalidades: soltero, casado, separado, divorciado y viudo.
Variable cualitativa ordinal o variable cuasicuantitativa
Una variable cualitativa ordinal presenta modalidades no númericas, en las que existe un orden.
Ejemplos:
La nota en un examen: suspenso, aprobado, notable, sobresaliente.
Puesto conseguido en una prueba deportiva: 1º, 2º, 3º, ...
Medallas de una prueba deportiva: oro, plata, bronce. Variable cuantitativa Una variable cuantitativa es la que se expresa mediante un número, por tanto se pueden realizar operaciones aritméticas con ella. Podemos distinguir dos tipos:
Variable discreta
Una variable discreta es aquella que solo puede tomar un número finito de valores entre dos valores cualesquiera de una característica.
Ejemplo:
El número de hermanos de 5 amigos: 2, 1, 0, 1, 3. Variable continua Una variable continua es aquella que puede tomar un número infinito de valores entre dos valores cualesquiera de una característica.
Ejemplos:
La altura de los 5 amigos: 1.73, 1.82, 1.77, 1.69, 1.75.
En la práctica medimos la altura con dos decimales, pero también se podría dar con tres decimales.
Distribución de frecuencias
La distribución de frecuencias o tabla de frecuencias es una ordenación en forma de tabla de los datos estadísticos, asignando a cada dato su frecuencia correspondiente.
Tipos de frecuencias
Frecuencia absoluta
La frecuencia absoluta es el número de veces que aparece un determinado valor en un estudio estadístico.
Se representa por fi.
La suma de las frecuencias absolutas es igual al número total de datos, que se representa por N.
Para indicar resumidamente estas sumas se utiliza la letra griega Σ (sigma mayúscula) que se lee suma o sumatoria.
Frecuencia relativa
La frecuencia relativa es el cociente entre la frecuencia absoluta de un determinado valor y el número total de datos.
Se puede expresar en tantos por ciento y se representa por ni.
La suma de las frecuencias relativas es igual a 1.
Frecuencia acumulada
La frecuencia acumulada es la suma de las frecuencias absolutas de todos los valores inferiores o iguales al valor considerado.
Se representa por Fi.
Frecuencia relativa acumulada
La frecuencia relativa acumulada es el cociente entre la frecuencia acumulada de un determinado valor y el número total de datos. Se puede expresar en tantos por ciento.
Ejemplo:
Durante el mes de julio, en una ciudad se han registrado las siguientes temperaturas máximas:
En la primera columna de la tabla colocamos la variable ordenada de menor a mayor, en la segunda hacemos el recuento y en la tercera anotamos la frecuencia absoluta. Este tipo de tablas de frecuencias se utiliza con variables discretas.
Distribución de frecuencias agrupadas
La distribución de frecuencias agrupadas o tabla con datos agrupados se emplea si las variables toman un número grande de valores o la variable es continua.
Se agrupan los valores en intervalos que tengan la misma amplitud denominados clases. A cada clase se le asigna su frecuencia correspondiente.
Límites de la clase
Cada clase está delimitada por el límite inferior de la clase y el límite superior de la clase.
Amplitud de la clase
La amplitud de la clase es la diferencia entre el límite superior e inferior de la clase.
Marca de clase
La marca de clase es el punto medio de cada intervalo y es el valor que representa a todo el intervalo para el cálculo de algunos parámetros.
1º Se localizan los valores menor y mayor de la distribución. En este caso son 3 y 48.
2º Se restan y se busca un número entero un poco mayor que la diferencia y que sea divisible por el número de intervalos queramos establecer.
Es conveniente que el número de intervalos oscile entre 6 y 15.
En este caso, 48 - 3 = 45, incrementamos el número hasta 50 : 5 = 10 intervalos.
Se forman los intervalos teniendo presente que el límite inferior de una clase pertenece al intervalo, pero el límite superior no pertenece intervalo, se cuenta en el siguiente intervalo.
SPSS es un programa estadístico informático muy usado en las ciencias sociales y las empresas de investigación de mercado. Originalmente SPSS fue creado como el acrónimo de Statistical Package for the Social Sciences aunque también se ha referido como "Statistical Product and Service Solutions" (Pardo, A., & Ruiz, M.A., 2002, p. 3).
Es uno de los programas estadísticos más conocidos teniendo en cuenta su capacidad para trabajar con grandes bases de datos y un sencillo interface para la mayoría de los análisis. En la versión 12 de SPSS se podían realizar análisis con 2 millones de registros y 250.000 variables. El programa consiste en un módulo base y módulos anexos que se han ido actualizando constantemente con nuevos procedimientos estadísticos. Cada uno de estos módulos se compra por separado.
Por ejemplo SPSS puede ser utilizado para evaluar cuestiones educativas.
Actualmente, compite no sólo con softwares licenciados como lo son SAS, MATLAB, Statistica, Stata, sino también con software de código abierto y libre, de los cuales el más destacado es el Lenguaje R. Recientemente ha sido desarrollado un paquete libre llamado PSPP, con una interfaz llamada PSPPire que ha sido compilada para diversos sistemas operativos como Linux, además de versiones para Windows y OS X. Este último paquete pretende ser un clon de código abierto que emule todas las posibilidades del SPSS.
Manejo del SPSS
SPSS tiene un sistema de ficheros en el cual el principal son los archivos de datos (extensión. SAV). Aparte de este tipo existen otros dos tipos de uso frecuente:
Archivos de salida (output, extensión. SPO): en estos se despliega toda la información de manipulación de los datos que realizan los usuarios mediante las ventanas de comandos. Son susceptibles de ser exportados con varios formatos (originalmente HTML, RTF o TXT, actualmente la versión 15 incorpora la exportación a PDF junto a los formatos XLS y DOC que ya se encontraban en la versión 12)
Archivos de sintaxis (extensión. SPS): Casi todas las ventanas de SPSS cuentan con un botón que permite hacer el pegado del proceso que el usuario desea realizar. Lo anterior genera un archivo de sintaxis donde se van guardando todas las instrucciones que llevan a cabo los comandos del SPSS. Este archivo es susceptible de ser modificado por el usuario. Muchos de los primeros usuarios del SPSS suelen escribir estos archivos en vez de utilizar el sistema de pegado del programa.
Existe un tercer tipo de fichero: el fichero de scripts (extensión. SBS). Este fichero es utilizado por los usuarios más avanzados del software para generar rutinas que permiten automatizar procesos muy largos y/o complejos. Muchos de estos procesos suelen no ser parte de las salidas estándar de los comandos del SPSS, aunque parten de estas salidas. Buena parte de la funcionalidad de los archivos de scripts ha sido ahora asumida por la inserción del lenguaje de programación Python en las rutinas de sintaxis del SPSS. Procedimientos que antes solo se podían realizar mediante scripts ahora se pueden hacer desde la sintaxis mismo.
El programa cuando se instala trae un determinado número de ejemplos o utilidades de casi todos los ficheros en cuestión. Estos son usados para ilustrar algunos de los ejemplos de uso del programa.
Aquí está una pequeña lista de cosas que se pueden hacer mediante este programa:
1.Introducción de datos:
Vamos a vista de datos y se introducen en DISTINTAS columnas (porque son distintas variables) de arriba abajo
2.Cálculos básicos:
-para hacer operaciones: ANALIZAR>>estadísticos descriptivos>>frecuencias (para tablas de frecuencias) ahí llevas la variable que te interese al otro lado y le das a estadísticos donde marcaremos todo lo que queramos saber (media, moda, mediana, cuartiles). Nos aparecerá una pantalla nueva con los resultados. Si necesitamos saber P2,5 o P97,5 habría que hacerlo aquí.
-ANALIZAR>>estadísticos descriptivos>>explorar: ahí introducimos la variable en el primer campo (lista de dependientes) y le damos a aceptar. Aquí nos da toda la información de antes pero ADEMÁS nos da el intervalo de confianza y estimación muestral así como el error típico de la media ENCIMA nos da las gráficas del diagrama tronco hojas y el de cajas.
-Para la ASIMETRIA y la KURTOSIS: En simetría: si es negativo está sesgada a la IZQUIERDA si es 0 es simétrica y si es positivo está sesgada a la DERECHA. En curtosis: si está rondando el 0 es mesocurtica, si es negativo platicúrtica y si es positiva leptocúrtica.
-ANALIZAR>>estadísticos descriptivos>>frecuencias>>gráficos esto es útil para ver la FORMA DE LA DISTRIBUCIÓN ya que podemos superponer la curva de la normal. Si la curva se parece al histograma podemos decir que es simétrica.
-Si por ejemplo queremos hacer una nube de puntos o un diagrama de dispersión para ver dos variables cuantitativas, vamos a Gráficos>>cuadro de diálogos antiguos>>dispersión puntos>>dispersión simple>>definir>> OJO hay que saber cual es la dependiente y cual la independiente. En función de será la X (dependiente (Y) e independiente (X)[la edad por ejemplo sería independiente en la mayoría de los casos])
-Otra cosa que podemos sacar es el coeficiente de correlación lineal de Pearson ANALIZAR>>correlaciones>>bivariadas. Ahí nos aparecerá una tabla. En una diagonal siempre nos saldrá 1 (no hacer caso) en el otro te aparecerá otro valor, que será el importante.
-El coeficiente de regresión y el coeficiente de determinación: ANALIZAR>>regresión>>lineal. De todas las tablas que hay, hay que fijarse en la que pone RESUMEN DEL MODELO y fijarse en la R2 (coeficiente de determinación). Para sacar el coeficiente de regresión (b) hay que mirar en una tabla llama COEFICIENTES. Ahí vemos dos números debajo de la B. La primera se llama constante (también denominada a) y el segundo es el coeficiente B de regresión. En resumen hay que coger el SEGUNDO.
-Si queremos contrastar dos medias: ANALIZAR>> comparar medias>>prueba t para muestras independientes>>definir grupos.
-Para hacer una selección de datos de una variable: DATOS>>Seleccionar casos>>Si satisface la condición>>Pones la variable a la derecha=(lo que quieras comparar) Ahora ya vamos a ANALIZAR>>explorar.
-ANALIZAR>>Estadístico descriptivo>>tablas de contingencia>>casillas>>% en filas>> aceptar
-ANALIZAR>>Estadísticos descriptivos>>Tablas de contingencia>>Mostrar gráfico de barras agrupados Y estadísticos>>(el estadístico que se quiera)
-ANALIZAR>>Comparar medias>>Prueba T para 1 muestra>>(ponemos el valor en valor de prueba)>>Aceptar `[Miramos en Sig]
-Si queremos cambiar el nombre a las variables para que sea más cómodo, se puede en VISTA DE VARIABLES (pestaña derecha) y clickas en el nombre.
La estadística
es una ciencia formal y una
herramienta que estudia el uso y los análisis provenientes de una muestra
representativa de datos, busca explicar las correlaciones y dependencias de un
fenómeno físico o natural, de ocurrencia en forma aleatoria o condicional.
Sin embargo, la estadística es más que eso, es
decir, es la herramienta fundamental que permite llevar a cabo el proceso
relacionado con la investigación científica.
Ambas ramas (descriptiva e inferencial) comprenden
la estadística aplicada. La
estadística inferencial, por su parte, se divide en estadística paramétrica y
estadística no paramétrica.
Hay también una disciplina llamada estadística matemática, la
que se refiere a las bases teóricas de la materia.
La palabra «estadísticas» también se refiere al
resultado de aplicar un algoritmo estadístico a un conjunto de datos, como en estadísticas
económicas, estadísticas
criminales, entre otros.
Origen de la
estadística
El término alemánStatistik,
introducido originalmente por Gottfried Achenwall en 1749,
se refería al análisis de datos del Estado,
es decir, la «ciencia del Estado» (o más bien, de la ciudad-estado). También se llamó aritmética política de acuerdo con la traducción literal del inglés. No fue hasta el siglo XIX cuando el término estadística adquirió el significado
de recolectar y clasificar datos. Este concepto fue introducido por el militar
británico sirJohn Sinclair
(1754-1835).
En su origen, por tanto, la
estadística estuvo asociada a los Estados o ciudades libres, para ser
utilizados por el gobierno y cuerpos administrativos (a menudo centralizados).
La colección de datos acerca de estados y localidades continúa ampliamente a
través de los servicios de estadística nacional e internacional. En particular,
los censos comenzaron a
suministrar información regular acerca de la población de cada país. Así pues, los datos estadísticos se
referían originalmente a los datos demográficos de una ciudad o Estado
determinados. Y es por ello que en la clasificación decimal de Melvil Dewey, empleada en las bibliotecas, todas las obras
sobre estadística se encuentran ubicadas al lado de las obras de o sobre la demografía. Ya se utilizaban
representaciones gráficas y otras medidas en pieles, rocas, palos de madera y
paredes de cuevas para controlar el número de personas, animales o ciertas
mercancías. Hacia el año 3000 a. C. los
babilonios usaban ya pequeños envases moldeados de arcilla para recopilar datos
sobre la producción agrícola y de los géneros vendidos o cambiados. Los
egipcios analizaban los datos de la población y la renta del país mucho antes
de construir las pirámides en el siglo XI a. C. Los libros bíblicos
de Números
y Crónicas incluyen en algunas partes
trabajos de estadística. El primero contiene dos censos de la población de la Tierra de Israel y el segundo describe el bienestar material
de las diversas tribus judías. En China existían registros
numéricos similares con anterioridad al año 2000 a. C. Los antiguos griegos realizaban censos
cuya información se utilizaba hacia el 594 a. C. para cobrar impuestos.
Su uso en la
probabilidad
Los métodos estadístico-matemáticos emergieron
desde la teoría de probabilidad, la cual data desde la
correspondencia entre Pascal y Pierre de Fermat (1654).
Christian Huygens (1657)
da el primer tratamiento científico que se conoce a la materia. El Ars coniectandi (póstumo, 1713)
de Jakob Bernoulli y la Doctrina de
posibilidades (1718) de Abraham de Moivre estudiaron la materia como una rama de las
matemáticas.1 En la era moderna, el trabajo de Kolmogórov ha sido un pilar en la formulación del modelo
fundamental de la Teoría de Probabilidades, el cual es usado a través de la
estadística.
La teoría de
errores se puede remontar a la Ópera miscellánea (póstuma, 1722) de Roger Cotes y al
trabajo preparado por Thomas Simpson en 1755
(impreso en 1756) el cual aplica por primera vez la teoría de la discusión de
errores de observación. La reimpresión (1757) de este trabajo incluye el axioma
de que errores positivos y negativos son igualmente probables y que hay unos
ciertos límites asignables dentro de los cuales se encuentran todos los
errores; se describen errores continuos y una curva de probabilidad.
Pierre-Simon Laplace
(1774) hace el primer intento de deducir una regla para la combinación de
observaciones desde los principios de la teoría de probabilidades. Laplace
representó la Ley de probabilidades de errores mediante una curva y dedujo una
fórmula para la media de tres observaciones. También, en 1871, obtiene la
fórmula para la ley de facilidad del error (término introducido por Lagrange, 1744) pero con ecuaciones inmanejables. Daniel Bernoulli (1778) introduce el principio del máximo
producto de las probabilidades de un sistema de errores concurrentes.
Ceres (el planeta enano)
vista por el telescopio espacial Hubble. La posición fue estimada por Gauss
mediante el método de mínimos cuadrados.
Hoy el uso de la estadística se ha extendido más
allá de sus orígenes como un servicio al Estado
o al gobierno. Personas y organizaciones usan la estadística para entender
datos y tomar decisiones en ciencias naturales y sociales, medicina, negocios y
otras áreas. La estadística es entendida generalmente no como un sub-área de
las matemáticas sino como una ciencia diferente «aliada». Muchas universidades tienen departamentos académicos de matemáticas y
estadística separadamente. La estadística se enseña en departamentos tan
diversos como psicología, educación y salud pública.
Al aplicar la estadística a un problema científico,
industrial o social, se comienza con un proceso o población a ser estudiado.
Esta puede ser la población de un país, de granos cristalizados en una roca o
de bienes manufacturados por una fábrica en particular durante un periodo dado.
También podría ser un proceso observado en varios instantes y los datos recogidos
de esta manera constituyen una serie de tiempo.
Por razones prácticas, en lugar de compilar datos
de una población entera, usualmente se estudia un subconjunto seleccionado de
la población, llamado muestra. Datos acerca de
la muestra son recogidos de manera observacional o experimental. Los datos son entonces analizados
estadísticamente lo cual sigue dos propósitos: descripción e inferencia.
El concepto de correlación es particularmente
valioso. Análisis estadísticos de un conjunto de datos puede revelar que dos variables (esto es,
dos propiedades de la población bajo consideración) tienden a variar
conjuntamente, como si hubiera una conexión entre ellas. Por ejemplo, un
estudio del ingreso anual y la edad de muerte podrían resultar en que personas
pobres tienden a tener vidas más cortas que personas de mayor ingreso. Las dos
variables se dice que están correlacionadas. Sin embargo, no se puede inferir
inmediatamente la existencia de una relación de causalidad entre las dos
variables. El fenómeno correlacionado podría ser la causa de una tercera,
previamente no considerada, llamada variable
confusora.
Si la muestra es representativa de la población,
inferencias y conclusiones hechas en la muestra pueden ser extendidas a la
población completa. Un problema mayor es el de determinar cuán representativa
es la muestra extraída. La estadística ofrece medidas para estimar y corregir
por aleatoriedad en la muestra y en el proceso de recolección de los datos, así
como métodos para diseñar experimentos robustos como primera medida, ver diseño experimental.
El uso de cualquier método estadístico es válido
solo cuando el sistema o población bajo consideración satisface los supuestos
matemáticos del método. El mal uso de la estadística puede producir serios
errores en la descripción e interpretación, lo cual podría llegar a afectar
políticas sociales, la práctica médica y la calidad de estructuras tales como
puentes y plantas de reacción nuclear.
Incluso cuando la estadística es correctamente
aplicada, los resultados pueden ser difíciles de interpretar por un inexperto.
Por ejemplo, el significado estadístico de una tendencia en los datos, que mide
el grado al cual la tendencia puede ser causada por una variación aleatoria en
la muestra, puede no estar de acuerdo con el sentido intuitivo. El conjunto de
habilidades estadísticas básicas y el escepticismo que una persona necesita
para manejar información en el día a día se refiere como «cultura estadística».